C-Eval 是什么
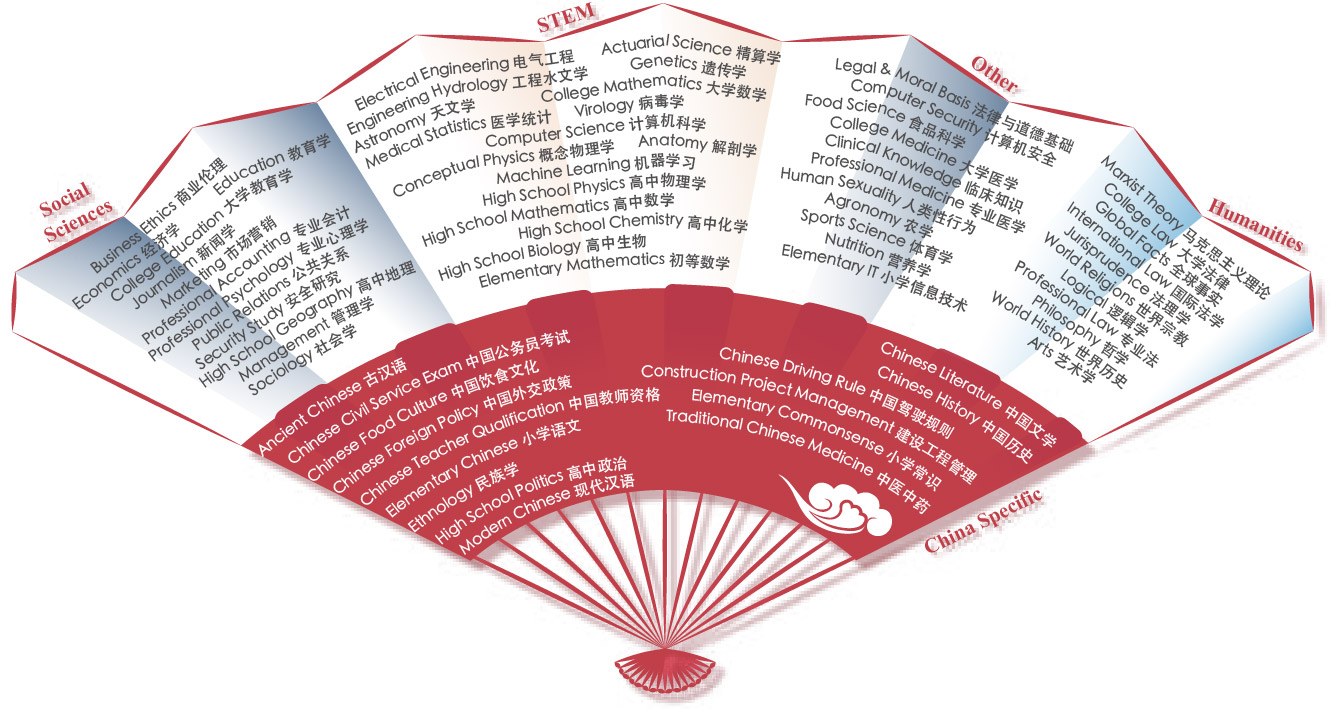
C-Eval 是用于评估基础模型中文能力的评测集合,官方仓库提供数据、评测方法和分学科结果。除了涵盖不同知识领域的主体测试,还设置包含较难数学、物理与化学题目的 C-Eval Hard。它适合研究者比较模型在中文知识和推理任务上的表现,使用时需要固定零样本或少样本设置,并查看分项得分与评测版本。 官方页面明确排行榜自 2025 年 7 月 26 日起不再更新,并公布测试集;本条保留的是评测基准资源,不提供实时排名建议。
适合谁,什么时候选
适合
适合中文模型能力对比。
不优先选择
用考试分数代替全部真实业务评估。
能力与限制
- 分科评测:按学科展示模型准确率。
- 困难子集:覆盖较复杂的数理化任务。
使用前留意
- 分数只反映对应题目与推理设置。
- 官方排行榜已停止更新,不反映当前模型竞争格局。
怎样开始了解 C-Eval
建议从下面的小任务开始;这是编辑建议,不是登录实测记录。
- 选择数据版本和提示设置。
- 运行并记录模型参数。
- 分析各学科错误样本。
使用条件
仓库公告2025年7月公开完整测试集;旧段落与新公告应区分。
来源与核验记录
官网失败,补读作者官方仓库。 2026-09-10 再复核:本次未取得完整产品正文,保留原资料范围,不代表当前功能实测。
- 资料整理
- 2026-09-10 · 公开资料已核对
- 实际测试
- 未进行登录后的实际效果测评
选型与步骤属于编辑建议。公开资料核对不等于付费功能测试;价格、地区和账号权益以实际使用时为准。