MagicArena
MagicArena的官方页面把自己定位为视觉大模型公开对战平台,面向图片和视频生成效果比较,并称参与对战后可得到个人模型排行榜。
AI模型评测
查找大模型评测平台、基准和榜单资源,了解评测范围与方法,不把单一榜单结果视为所有任务的实际表现。
MagicArena的官方页面把自己定位为视觉大模型公开对战平台,面向图片和视频生成效果比较,并称参与对战后可得到个人模型排行榜。
中文大模型评测基准与数据资源;官方排行榜已停止更新,不作为当前模型实时排名。
FlagEval天秤是智源研究院的大模型评测平台,围绕自然语言、视觉和多模态等领域组织数据集、评测规则及结果展示。
面向中文大模型的综合评测项目,覆盖语言、知识、智能体与安全等能力。
AGI-Eval是用于大语言模型评测的开源框架,采用插件化设计,将数据处理、模型推理、指标计算和报告生成分开组织。
OpenCompass 司南是面向大模型开发者和使用者的评测平台与开源工具,提供榜单、评测集信息及可运行的评测流程。
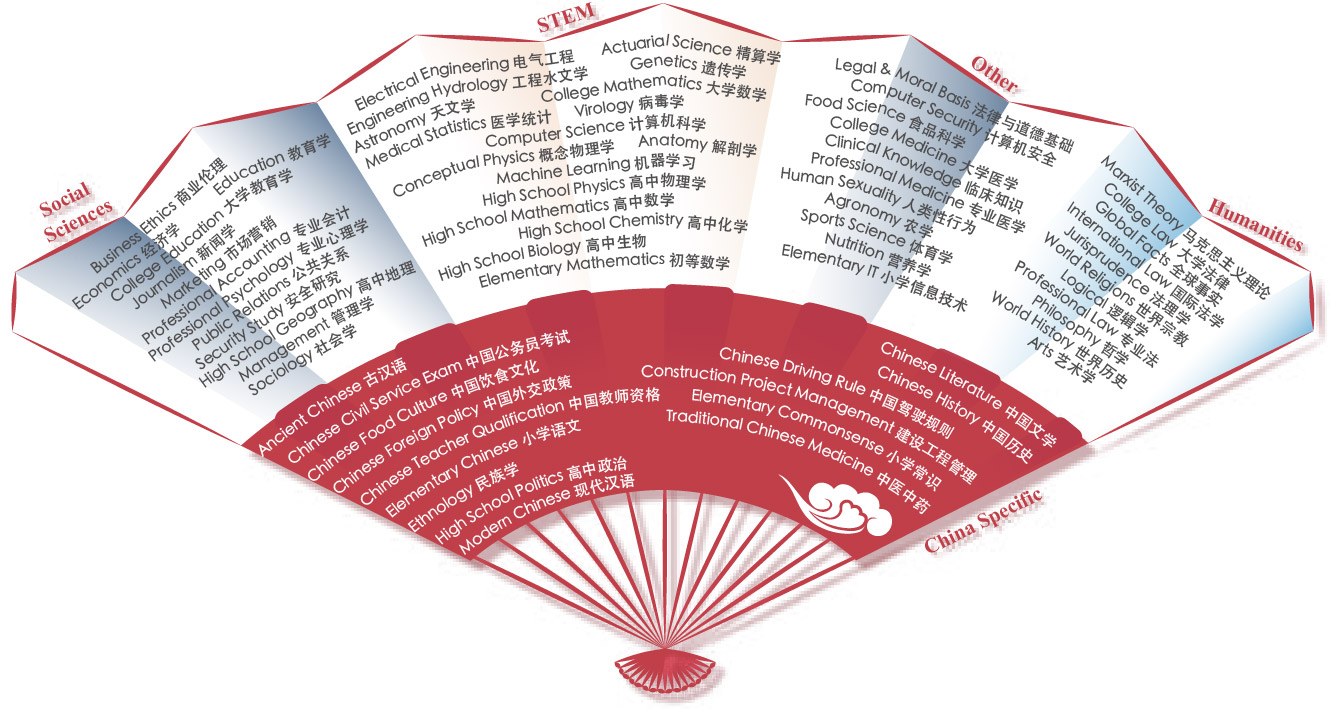
CMMLU 是评估语言模型中文知识与推理能力的基准数据集,覆盖67个主题,包含自然科学、人文社会科学及具有中国语境的知识问题。
MMBench 是评估视觉语言模型能力的公开基准,由题目数据和评测方法组成。
HELM 是斯坦福 CRFM 提供的模型评测框架与结果浏览平台,通过多个任务场景比较基础模型表现。
Arena 是通过用户比较模型回答收集偏好、形成排行榜的平台。
LLMEval3 的原入口当前展示的是复旦相关团队的 LLMEval 评测研究系列,已经不只是一个单独的旧版排行页面。
所给“H2O EvalGPT”链接当前对应H2O Eval Studio,是用于评估大语言模型和检索增强应用的工具。
支持多种数据标注、人工反馈和 AI 评估的开源平台。
通过配置化测试比较提示词、模型和 RAG 输出,支持结果查看与持续集成检查。
面向 LLM、RAG 与智能体的 Python 评估框架,可将测试样例接入自动化回归检查。